


Dans beaucoup d’organisations, le mot « service » est utilisé dans tous les sens, service informatique, service RH, service client, mais aussi « niveau de service », « service support », « service rendu ». Résultat, on empile des demandes, on se renvoie des tickets, et personne n’a une vision claire des responsabilités, des priorités et des outils nécessaires.
L’objectif de cet article est simple : clarifier ce qu’est un service dans une entreprise, détailler les rôles qui le font fonctionner, les outils qui structurent l’exécution, et les bonnes pratiques qui permettent de délivrer un résultat constant, mesurable et sécurisé, en particulier lorsque l’IT et la cybersécurité deviennent des fonctions vitales.
Qu’est-ce qu’un « service » dans une entreprise ? (et pourquoi c’est plus qu’un organigramme)
Dans une entreprise, un service est généralement une unité organisée qui a :
- une mission (ce qu’il doit produire ou garantir),
- un périmètre (ce qui est dedans, ce qui est hors périmètre),
- des clients internes ou externes (qui consomme ce service),
- des moyens (personnes, budget, outils),
- des règles de pilotage (priorités, indicateurs, engagements).
Un service peut être « productif » (production, exploitation, commerce) ou « support » (RH, finance, IT). Dans les deux cas, la performance dépend surtout de la qualité des interfaces avec les autres équipes.
Un bon repère consiste à raisonner comme en gestion de services : un service existe si l’on peut décrire clairement ce qui est fourni, à qui, avec quel délai, à quel niveau de qualité, et comment on mesure.
Les rôles clés dans un service (et leurs responsabilités)
Un service fonctionne rarement grâce à un seul bon manager ou à un outil “magique”. Il fonctionne quand les responsabilités sont explicites et acceptées.
Direction et pilotage : donner le cadre
La Direction (DG, Direction métier, Direction de site) fixe le cadre :
- objectifs et priorités (croissance, conformité, réduction des risques, qualité),
- niveau de risque acceptable (notamment cyber),
- budget, arbitrages, choix d’externalisation.
Sans ce cadrage, les services opèrent « au fil de l’eau » et finissent par traiter l’urgent au détriment de l’important.
Responsable de service : transformer des objectifs en exécution
Le responsable de service (chef de service, manager, responsable support, DSI, RSSI selon le domaine) est le point d’équilibre entre les attentes et les moyens. Il doit :
- formaliser le périmètre (ce que l’équipe prend en charge),
- définir les processus (comment on traite incidents, demandes, changements),
- organiser la capacité (planning, astreintes, charge, sous-traitance),
- piloter la qualité (indicateurs, plans d’amélioration).
Référents métiers : éviter l’effet « ticket ping-pong »
Les référents métiers sont souvent sous-estimés. Ce sont eux qui permettent :
- de qualifier correctement une demande (contexte, impact, urgence),
- de valider qu’un besoin est bien couvert,
- d’anticiper les périodes critiques (clôtures comptables, pics d’activité, campagnes commerciales).
Utilisateurs : une responsabilité réelle (pas seulement “demandeurs”)
Dans une logique mature, les utilisateurs ont aussi des responsabilités :
- signaler correctement (exemples, captures, heure, impact),
- appliquer les règles (MFA, mots de passe, mises à jour, procédures),
- participer aux tests lors des changements.
En cybersécurité, ce point est central. L’ANSSI rappelle régulièrement l’importance des mesures organisationnelles et humaines en complément des mesures techniques (voir les ressources sur le site de l’ANSSI).
Exemple de répartition simple des responsabilités
| Sujet | Responsable (accountable) | Exécutant (responsible) | Contributeurs (consulted) | Informés (informed) |
|---|---|---|---|---|
| Priorités et budget | Direction | Responsable de service | Métiers, finance | Tous |
| Traitement d’incident | Responsable de service | Support/IT | Métiers, fournisseurs | Utilisateurs |
| Changement (mise à jour, migration) | Responsable de service | IT/projet | Sécurité, métiers | Tous |
| Gestion des accès | Responsable sécurité/DSI | IT | RH, managers | Utilisateurs |
| Continuité (PRA/PCA) | Direction | IT + métiers | Prestataires | Tous |
(Les intitulés varient selon la taille de l’entreprise, l’important est la clarté des rôles.)
Structurer un service : les 5 fondations qui évitent la confusion
1) Définir la mission et le périmètre (noir sur blanc)
Un service “efficace” n’est pas celui qui dit oui à tout, c’est celui qui sait :
- ce qu’il prend en charge,
- ce qu’il ne prend pas en charge,
- ce qu’il peut traiter immédiatement,
- ce qui doit passer par un projet.
En IT par exemple, c’est la différence entre une demande standard (création de compte, installation validée) et un projet (nouveau site, refonte réseau, migration cloud).
2) Désigner un point d’entrée (et un circuit de traitement)
Sans point d’entrée, on obtient : appels directs, messages WhatsApp, mails à des personnes, demandes orales, puis aucune traçabilité.
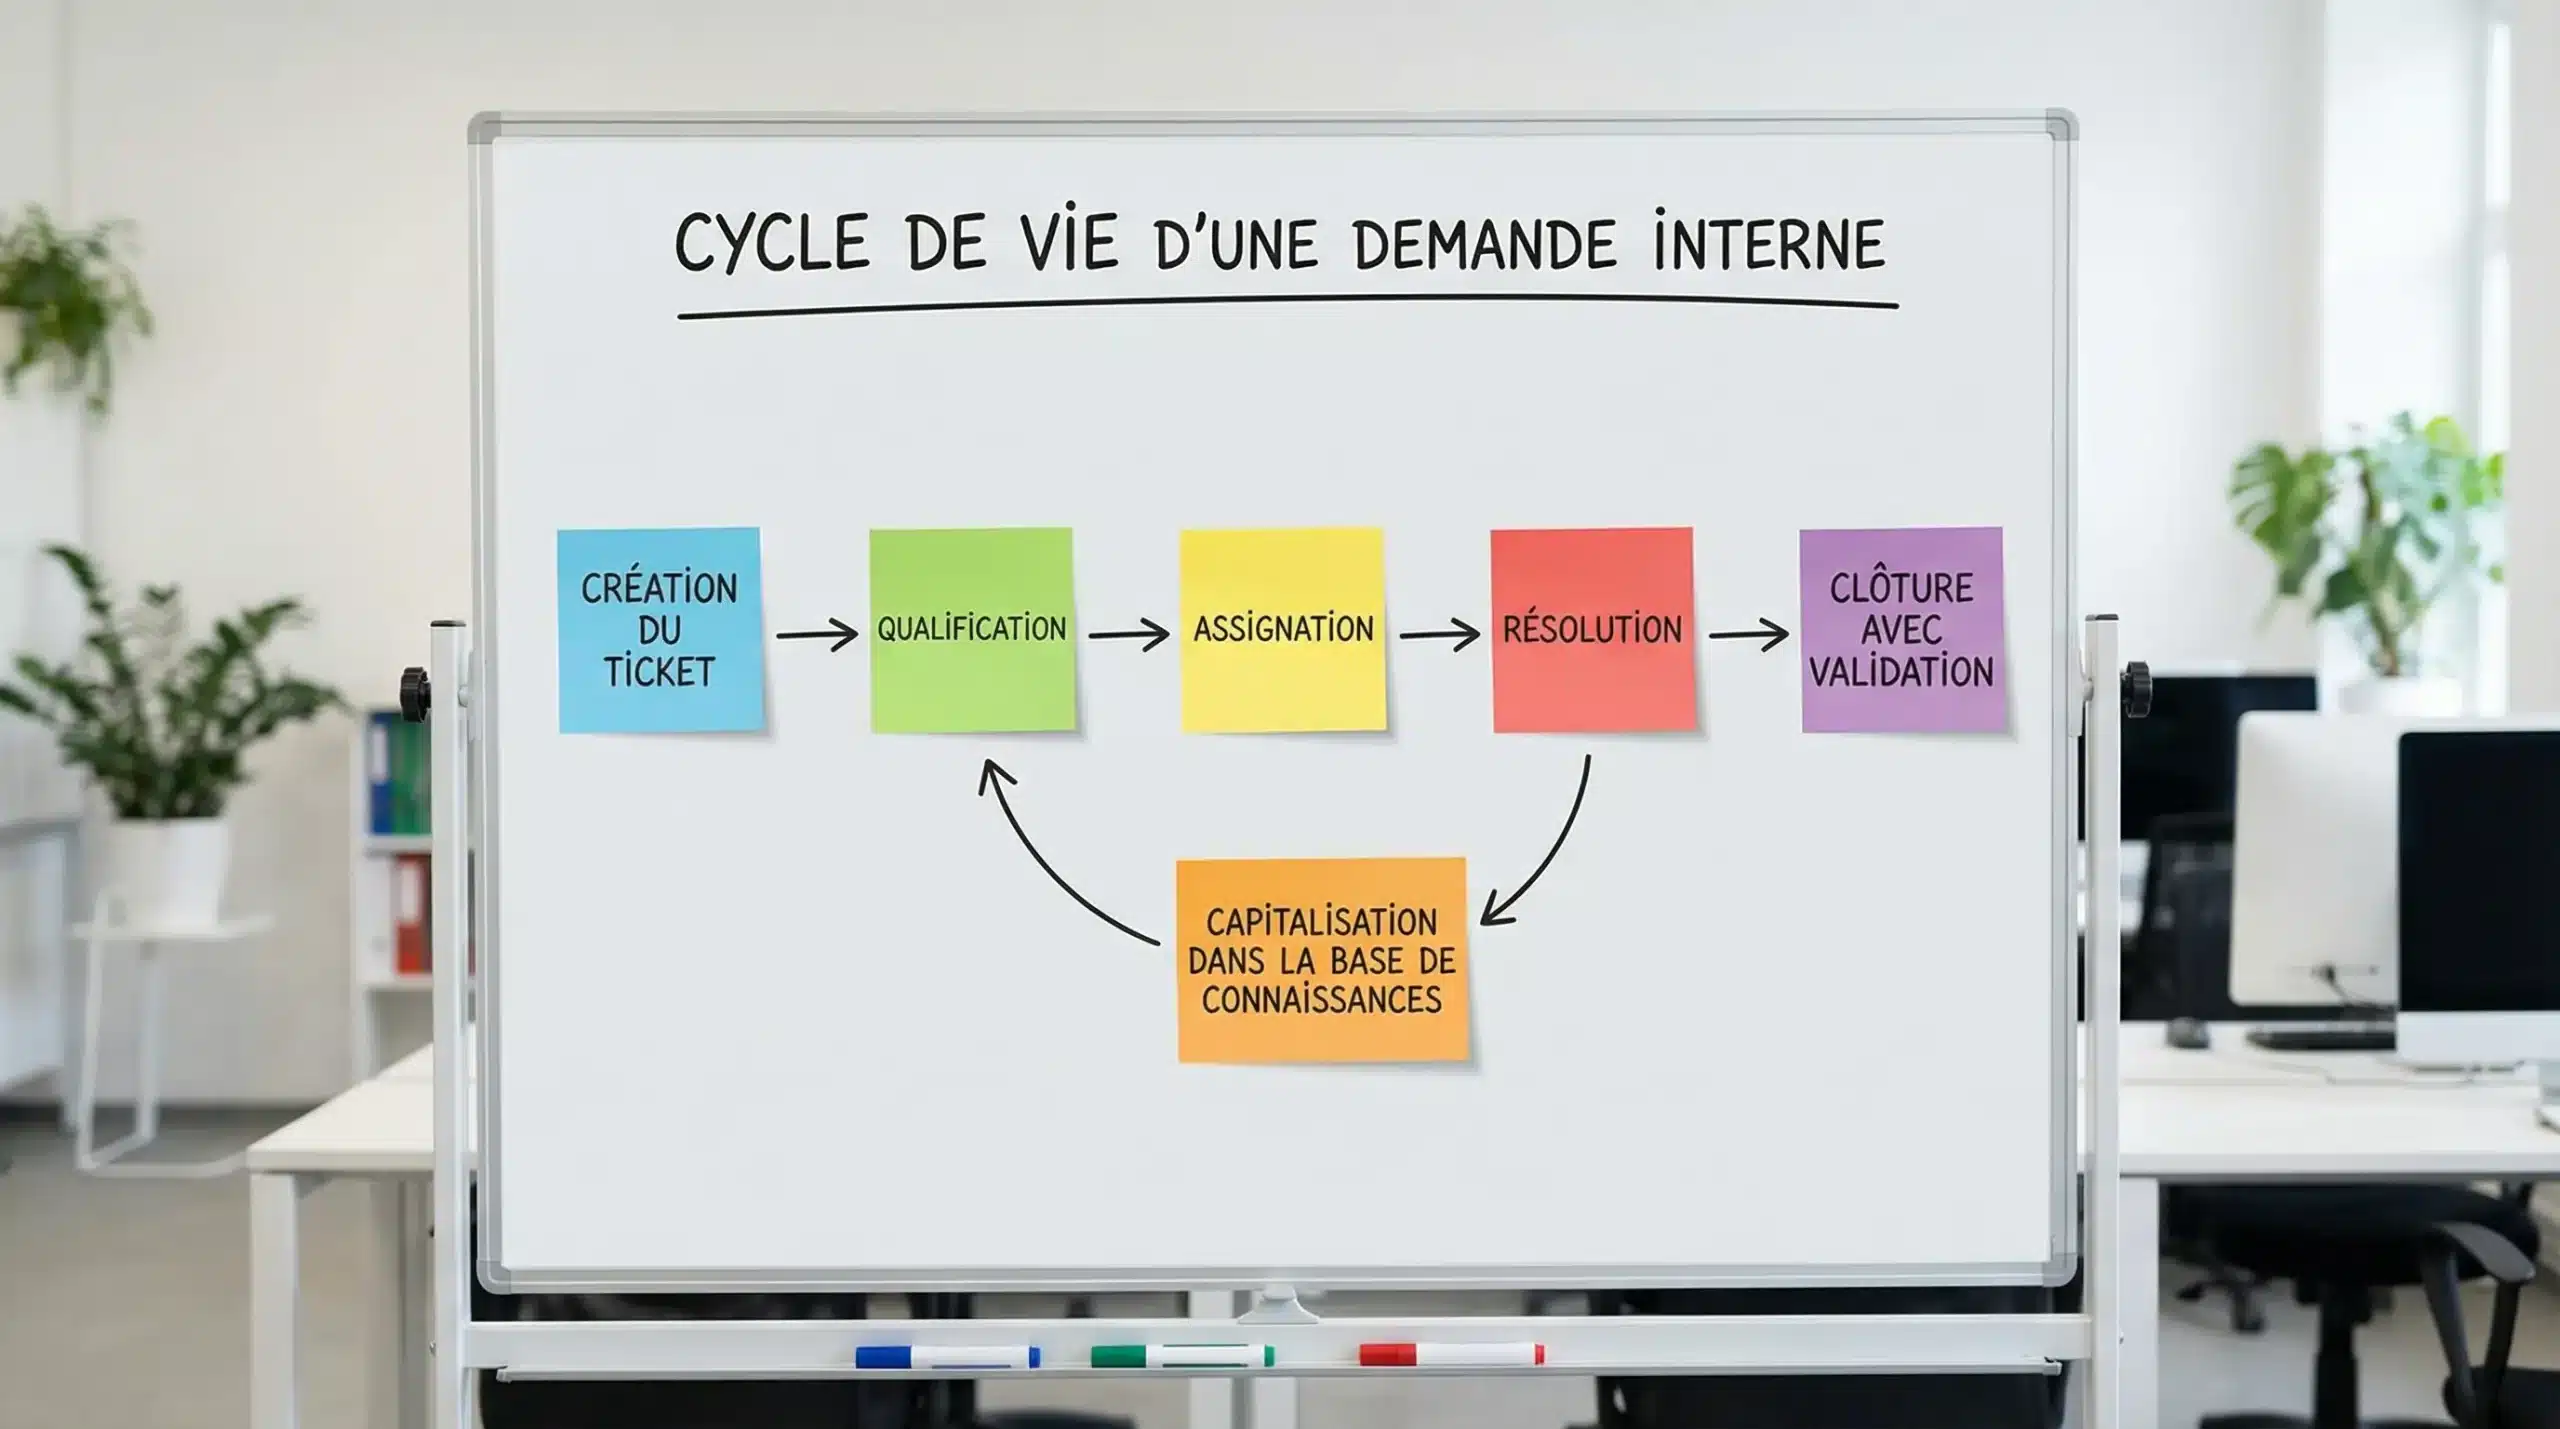
La bonne pratique consiste à imposer un canal officiel (souvent un outil de ticketing) et à standardiser :
- la qualification (catégorie, impact, urgence),
- la priorisation,
- l’escalade,
- la clôture avec validation.
Pour le sujet spécifique, vous pouvez aussi lire l’article MDSI sur le Service Desk, qui décrit le principe de point de contact unique.
3) Créer un catalogue de services (même minimal)
Un catalogue de services n’a pas besoin d’être long. Il doit surtout éviter les malentendus.
Exemples d’entrées utiles :
- création/modification de compte et droits,
- poste de travail (installation, remplacement, dépannage),
- messagerie et collaboration,
- impression,
- accès distant,
- réseau et Wi-Fi,
- sauvegarde et restauration,
- sécurité (MFA, antivirus/EDR, filtrage, sensibilisation).
Chaque entrée précise : conditions, délais cibles, éléments nécessaires, et éventuels coûts internes.
4) Formaliser des engagements de service (SLA) réalistes
Les SLA (Service Level Agreements) servent à aligner les attentes. Ils doivent correspondre à la réalité opérationnelle.
Quelques exemples d’engagements (à adapter) :
- délai de prise en charge,
- délai de rétablissement cible selon priorité,
- disponibilité d’un service critique,
- délai de livraison d’un poste.
Si vous externalisez, les SLA deviennent contractuels. Le sujet est détaillé dans le guide MDSI sur le contrat d’infogérance et ses clauses SLA.
5) Mettre en place une boucle d’amélioration continue
Un service progresse quand il exploite ses données : top incidents, causes récurrentes, postes obsolètes, applications instables, erreurs humaines fréquentes.
C’est là que les revues mensuelles (qualité, sécurité, budget, risques) font la différence, surtout dans les PME où tout le monde manque de temps.
Les outils indispensables (selon la maturité et la taille)
On confond souvent « outils » et « logiciels ». En réalité, un service fiable repose sur un écosystème : outils, procédures, documentation, et règles d’exploitation.
Panorama des familles d’outils utiles
| Besoin | Outils typiques | Objectif |
|---|---|---|
| Ticketing et demandes | ITSM / helpdesk | Traçabilité, priorisation, SLA |
| Base de connaissances | Wiki, KBase intégrée | Résolution plus rapide, capitalisation |
| Inventaire et actifs | Gestion de parc, CMDB | Savoir “ce qu’on a”, réduire les angles morts |
| Supervision | Monitoring infra et applicatif | Détecter avant les utilisateurs |
| Sécurité des accès | IAM, MFA, gestion des comptes | Réduire le risque d’intrusion |
| Sauvegarde | Backup, tests de restauration | Continuité, résilience ransomware |
| Collaboration | Messagerie, chat, visio | Fluidifier les échanges sans perdre l’info |
| Pilotage | Tableaux de bord, reporting | Décider sur des faits |
Sur les volets conformité et données personnelles, la CNIL propose des ressources pratiques, notamment pour structurer la démarche RGPD (voir le site de la CNIL).
Les 3 erreurs d’outillage les plus fréquentes
-
Avoir plusieurs canaux concurrents (mail + WhatsApp + téléphone + outil), ce qui détruit la visibilité.
-
Ne pas documenter : la même panne revient, mais personne ne sait comment elle avait été résolue.
-
Superviser sans processus : recevoir des alertes ne sert à rien si personne n’est responsable de l’analyse, de l’escalade et du correctif.
Bonnes pratiques concrètes pour un service IT (et transposables aux autres services)
Même si chaque service a ses spécificités, l’IT est un bon exemple car il combine production, support, risque, et dépendances externes (éditeurs, opérateurs, cloud).
Séparer “Run” et “Build” (exploitation vs projets)
Beaucoup d’équipes souffrent car elles tentent de gérer au même moment :
- le quotidien (incidents, demandes),
- les changements (mises à jour, nouveaux outils),
- les projets structurants (migration, nouveau site, refonte sécurité).
Sans séparation minimale (même si ce n’est pas deux équipes distinctes), les projets prennent du retard et le quotidien se dégrade.
Standardiser la gestion des incidents et des changements
Deux processus “simples” apportent vite de la maturité :
- Gestion des incidents : rétablir rapidement, communiquer, puis analyser les causes.
- Gestion des changements : planifier, évaluer le risque, tester, prévoir un retour arrière.
Ces approches sont cohérentes avec les référentiels de gestion des services (par exemple ITIL, AXELOS).
Construire une posture “résilience” (pas uniquement “protection”)
En 2026, le sujet n’est plus seulement d’éviter l’incident, mais aussi de reprendre vite.
Concrètement, cela se traduit par :
- sauvegardes structurées, dont la règle 3-2-1 et des tests de restauration (voir le guide MDSI sur la sauvegarde de données professionnelles),
- objectifs de reprise (RTO/RPO) alignés sur les métiers (voir l’article sur le Plan de Reprise d’Activité),
- supervision, patch management, et réduction de la surface d’attaque.
Ancrer la cybersécurité dans le service (et pas “à côté”)
La sécurité est souvent vue comme un frein. En réalité, elle devient un accélérateur quand elle est intégrée dans les pratiques :
- MFA généralisée sur les comptes sensibles,
- gestion stricte des droits (moindre privilège),
- durcissement des postes et serveurs,
- sensibilisation régulière, notamment au phishing.
Sur ce dernier point, l’article MDSI sur la cybersécurité à La Réunion donne un panorama très concret des menaces et des mesures prioritaires.
Mesurer la performance : des KPI utiles (et actionnables)
Un indicateur utile doit déclencher une action. Sinon, c’est du reporting décoratif.
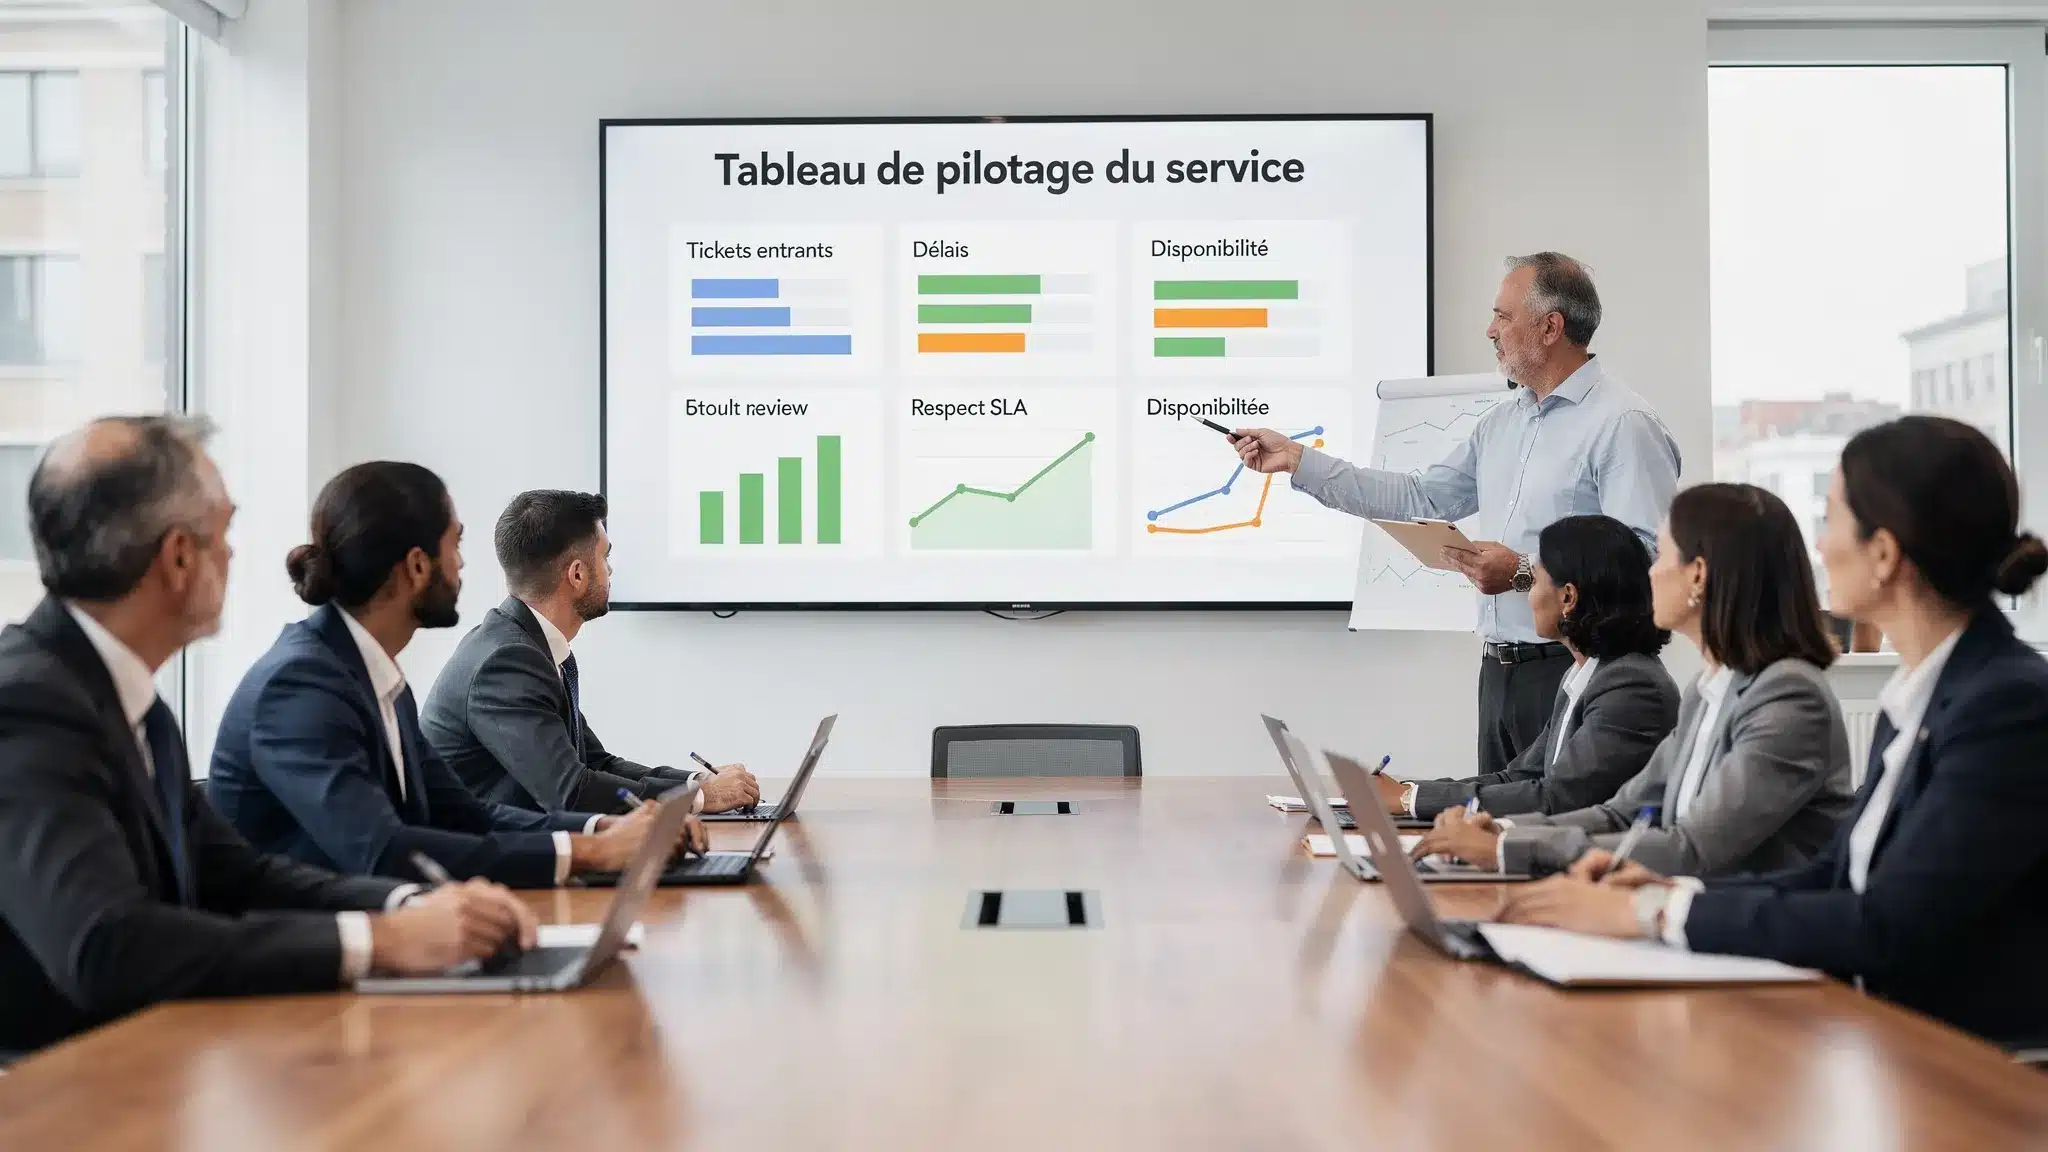
Voici des KPI souvent pertinents pour un service support ou IT :
- volume de tickets entrants (par catégorie),
- délai de première réponse,
- taux de respect des SLA,
- temps moyen de résolution (avec prudence, à croiser avec la complexité),
- taux de réouverture (qualité de résolution),
- part des incidents récurrents (problème non traité à la racine),
- taux de satisfaction utilisateur (CSAT) sur un échantillon,
- disponibilité des services critiques.
Tableau de lecture rapide : KPI et décisions associées
| KPI observé | Ce que ça peut indiquer | Décision typique |
|---|---|---|
| Hausse des incidents récurrents | dette technique, obsolescence, mauvaise documentation | plan de fiabilisation, remplacement, standardisation |
| Délai de réponse trop long | manque de capacité, canaux multiples, mauvaise priorisation | renforcer le support, imposer le SPOC, requalifier |
| SLA non tenus sur une catégorie | processus inadapté, dépendance fournisseur | revoir SLA, renégocier, mieux outiller |
| Satisfaction en baisse | communication insuffisante, perception de lenteur | améliorer la communication, publier des statuts |
Internaliser ou externaliser un service : comment décider sans se tromper
La question n’est pas « externaliser ou pas », mais « quel périmètre externaliser, avec quel niveau de contrôle ».
Quand l’internalisation est souvent pertinente
- besoin très spécifique au métier,
- forte sensibilité des données et des processus,
- volume de demandes justifiant une équipe dédiée,
- capacité à recruter et à maintenir des compétences.
Quand l’externalisation devient un levier
- difficulté à recruter localement ou à couvrir les absences,
- besoin de compétences pointues (cybersécurité, cloud, virtualisation) ponctuelles ou permanentes,
- besoin de supervision et de réactivité, y compris hors horaires,
- volonté de maîtriser les coûts et d’industrialiser.
Pour cadrer ce choix, un audit apporte souvent une vision factuelle (inventaire, risques, obsolescence, dépendances). Voir l’article MDSI sur l’audit informatique à La Réunion.
Si vous envisagez l’externalisation, l’article « À qui s’adresse l’infogérance ? » aide à situer les cas typiques, et celui sur les tarifs moyens de l’infogérance à La Réunion donne des repères pour lire un devis (sans se focaliser uniquement sur le prix).
Spécificités La Réunion et Mayotte : des contraintes qui changent les bonnes pratiques
Dans les territoires insulaires, certains paramètres amplifient les enjeux de service :
- dépendance à la connectivité (et parfois à des points de sortie uniques),
- contraintes de délai d’approvisionnement matériel,
- risques climatiques (événements cycloniques, humidité) qui impactent infrastructure, énergie, disponibilité,
- besoin de proximité pour des interventions et une coordination efficace.
C’est aussi pour cela que la résilience (sauvegardes, PRA, hébergement et exploitation robustes) doit être pensée comme un socle, pas comme une option.
Mettre en place une démarche simple en 30 jours (sans usine à gaz)
Si vous partez de zéro ou d’une organisation “informelle”, visez un résultat pragmatique :
- un point d’entrée unique pour les demandes,
- un catalogue minimal (10 à 20 entrées),
- 3 niveaux de priorité clairement expliqués,
- un engagement de prise en charge et une règle de communication,
- une base de connaissances avec 10 procédures critiques (création de compte, MFA, restauration, Wi-Fi, imprimantes, VPN, etc.),
- une revue mensuelle avec 5 KPI.
Ce socle suffit souvent à réduire fortement l’irritation interne, à améliorer la sécurité opérationnelle, et à rendre les décisions plus faciles.
Besoin de clarifier vos rôles, outiller votre support ou sécuriser votre IT ?
Quand les services sont mal définis, l’entreprise paye deux fois : en temps perdu et en risque (pannes, incidents de sécurité, non-conformité, perte de productivité). Une démarche structurée, basée sur un périmètre clair, des processus simples et des outils adaptés, permet généralement d’obtenir des gains visibles rapidement.
MDSI accompagne les entreprises de La Réunion et Mayotte sur ces sujets (audit, infogérance, cloud, cybersécurité, continuité). Pour partir sur des bases factuelles, vous pouvez demander un premier échange via le site MDSI et définir ensemble le bon niveau de service, les responsabilités, et les priorités à sécuriser en premier.


